
Comment supprimer les lignes en double d'un fichier CSV
Comment trouver et supprimer correctement les lignes en double dans un export CSV — en choisissant les bonnes colonnes de correspondance et en décidant quelle copie garder.
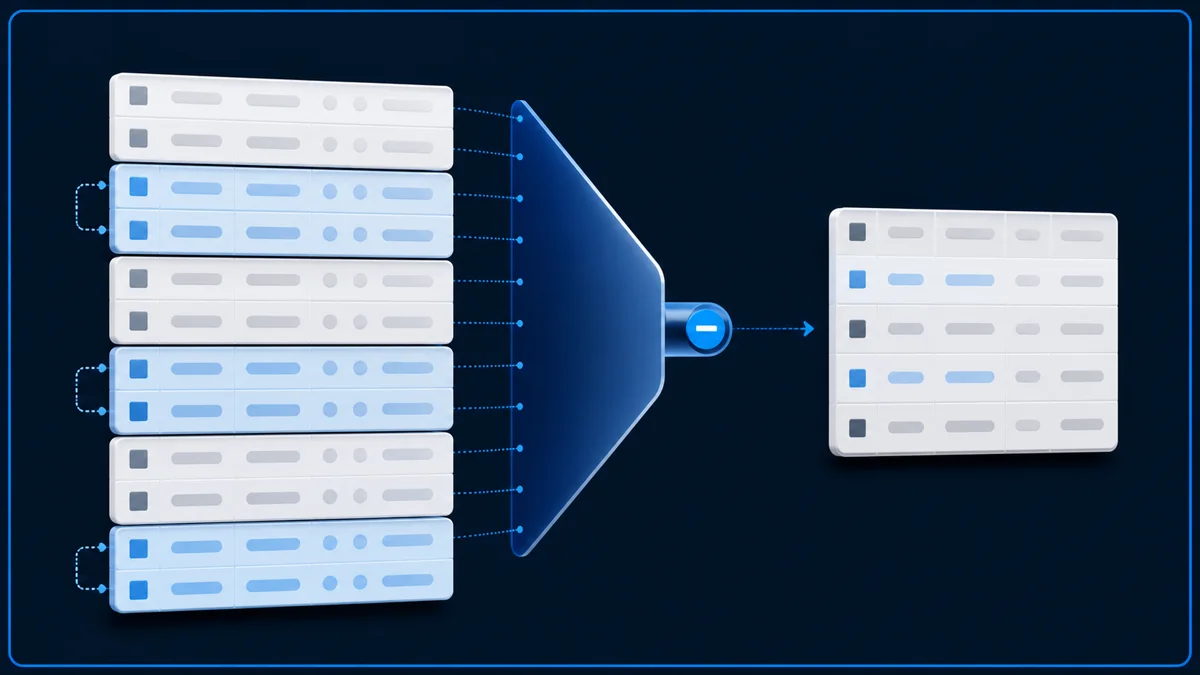
Supprimez les lignes en double d’un seul CSV directement dans votre navigateur sans téléverser le fichier, jusqu’à 500 MB. Cette limite publiée a été vérifiée sur cinq types de fichier différents, trois fois chacun, pour confirmer la justesse des résultats (15 exécutions au total).
Ces 15 exécutions couvraient cinq formes de fichier : des données courantes, beaucoup de valeurs différentes dans les colonnes de correspondance, de longues valeurs de correspondance, des lignes très larges et des données riches en doublons avec conservation de la dernière occurrence. Chaque forme a été exécutée trois fois et la sortie a été vérifiée. Le cas de 500 MiB le plus exigeant était celui avec beaucoup de valeurs de correspondance différentes : ses trois exécutions ont pris 43,1, 57,9 et 85,7 minutes et ont nécessité environ 1,472 GiB d'espace temporaire sur votre propre ordinateur. Ces mesures étayent la limite actuelle affichée sur l'outil, mais ce type de fichier peut prendre beaucoup de temps et nécessite assez d'espace disque libre.
Les lignes en double s'invitent dans les exports CSV pour des raisons banales : un formulaire envoyé deux fois, une tâche de synchronisation exécutée deux fois, ou un export de tableur qui a inclus le même enregistrement depuis deux systèmes sources. Avant de pouvoir faire confiance à un fichier pour un import, vous devez supprimer les doublons — correctement, pas seulement les correspondances exactes évidentes.
Doublons exacts vs. doublons logiques
Un doublon exact est une ligne qui correspond exactement à une autre dans chaque champ. Ceux-là sont faciles à repérer. Un doublon logique est plus subtil : deux lignes qui représentent le même enregistrement du monde réel mais diffèrent légèrement, comme le même client avec deux numéros de téléphone différents, ou le même produit avec une faute de frappe dans le nom.
Décider de ce qui compte comme « le même enregistrement » est une décision métier, pas technique — elle dépend de la colonne, ou de la combinaison de colonnes, qui identifie de façon fiable une entité unique dans vos données.
Choisir les colonnes de correspondance
| Type de donnée | Clé forte | Clé faible (à éviter seule) |
|---|---|---|
| Clients | prénom | |
| Produits | SKU | nom du produit |
| Entreprises | domaine / SIREN | nom de l'entreprise |
Quand aucune colonne seule n'est fiable, faites correspondre sur une combinaison — par exemple nom plus date de naissance, ou entreprise plus adresse de facturation. Une combinaison trop large produit des faux positifs ; une combinaison trop étroite produit des faux négatifs.
Testez votre règle de correspondance sur un échantillon avant de la lancer sur le fichier complet. Une clé trop large peut fusionner deux clients différents en un seul ; une clé trop stricte peut laisser passer de vrais doublons.
Ce qui compte comme doublon
L'outil traite deux lignes comme doublons uniquement si chaque colonne clé sélectionnée a la même valeur élaguée. Les espaces en début ou en fin de cellule clé sont ignorés, donc deux lignes qui ne diffèrent que par des espaces autour restent un doublon. La casse et la ponctuation à l'intérieur de la cellule ne sont pas normalisées — « Acme Corp » et « acme corp. » sont des clés différentes.
Quand vous sélectionnez plus d'une colonne clé, deux lignes ne correspondent que si chaque colonne sélectionnée correspond. La limite actuelle est de 500 MB par fichier. Le travail reste sur votre appareil — rien n'est téléversé.
- 01
Importez un fichier CSV.
Choisissez le fichier contenant les lignes en double. Rien n'est téléversé — le fichier est lu et traité dans votre navigateur.
- 02
Choisissez une ou plusieurs colonnes pour la correspondance des doublons.
Sélectionnez les colonnes qui identifient ensemble un enregistrement unique, comme l'e-mail seul, ou l'entreprise plus le nom du contact. Choisir la mauvaise colonne déclenche une erreur d'analyse plutôt que de produire silencieusement un mauvais résultat.
- 03
Conservez la première ou la dernière occurrence.
Conserver la première préserve la ligne apparue le plus tôt dans le fichier. Conserver la dernière préserve l'entrée la plus récente. Choisissez celle qui correspond au tri de votre fichier et à la copie qui porte les données auxquelles vous faites confiance.
- 04
Examinez les groupes de doublons et l'aperçu nettoyé.
L'outil affiche combien de groupes de doublons ont été trouvés et un aperçu du fichier nettoyé avant le téléchargement. C'est le moment de confirmer que la règle de clé correspond bien à ce que vous aviez en tête.
- 05
Téléchargez le fichier nettoyé ou les lignes supprimées.
Les deux fichiers sont générés : un avec les doublons supprimés et un avec tout ce qui a été filtré. Le fichier source n'est jamais modifié.
Conserver la première ou la dernière ?
Une fois les doublons regroupés, vous avez besoin d'une règle pour décider quelle copie survit.
- 01
Conserver la première
Préserve la ligne apparue le plus tôt — utile quand le fichier est trié du plus ancien au plus récent et que vous voulez l'enregistrement d'origine.
- 02
Conserver la dernière
Préserve l'entrée la plus récente — utile quand les lignes suivantes représentent des corrections ou des mises à jour.
- 03
Vérifier manuellement
Si aucune règle ne convient, inspectez les groupes de doublons avant de décider. Une règle automatique peut silencieusement écarter de bonnes données.
Toujours conserver les lignes supprimées
Un processus de suppression des doublons responsable ne se contente pas de supprimer des lignes — il exporte ce qui a été retiré en plus du fichier nettoyé, pour que vous puissiez vérifier la décision et récupérer une ligne si la règle de correspondance était trop agressive. Le fichier des lignes supprimées utilise le même ordre de colonnes et le même délimiteur que la source, pour qu'il puisse être ouvert ou refusionné sans travail supplémentaire. Si une ligne est supprimée par erreur, copiez-la depuis ce fichier plutôt que de relancer le nettoyage sur une nouvelle source.
Si les lignes en double contiennent des valeurs différentes et que vous devez choisir laquelle conserver, consultez d'abord le guide première ou dernière occurrence.
Supprimer les doublons CSVVoir la transformation
Les enregistrements répétés deviennent un fichier propre et vérifiable.
Les lignes répétées sont retirées du fichier propre et restent faciles à vérifier.
✓ Le fichier propre garde un exemplaire
Besoin de le faire maintenant ?
Supprimer les doublons CSVOutils associés
Ouvrez l'outil dont parle ce guide, ou explorez un outil associé.
- Nettoyer et réparer un fichier CSV gratuitementRéparez les problèmes CSV courants : délimiteurs incorrects, lignes inégales, lignes vides, espaces, marqueurs BOM et en-têtes en double.
- Comparer des fichiers CSV en ligne gratuitementComparez deux fichiers CSV et examinez les lignes ajoutées, supprimées et modifiées directement dans votre navigateur.
- Mappeur et renommeur de colonnes CSVRenommez, réorganisez et supprimez des colonnes CSV avant d'importer des données dans un CRM, une boutique, une base de données ou un système comptable, sans téléverser vos fichiers.