
Doppelte Zeilen aus einer CSV-Datei entfernen
So finden und entfernen Sie doppelte Zeilen in einem CSV-Export korrekt — mit den richtigen Abgleichsspalten und einer klaren Entscheidung, welche Kopie erhalten bleibt.
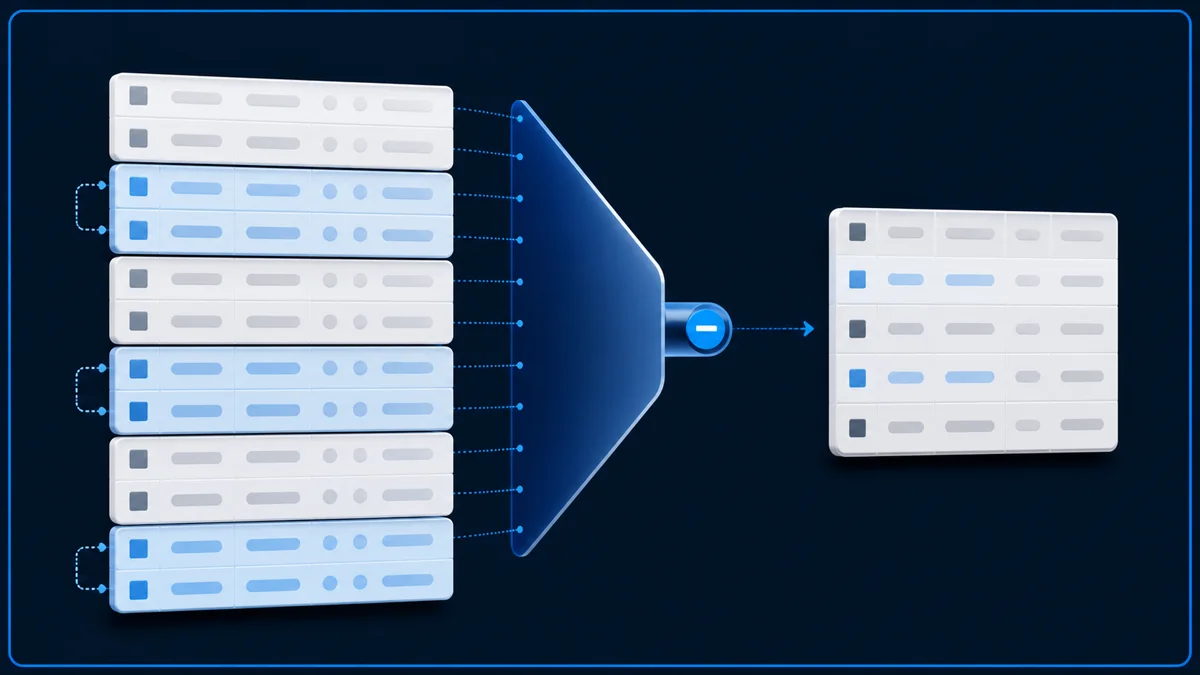
Entfernen Sie doppelte Zeilen aus einer CSV-Datei direkt im Browser, ohne die Datei hochzuladen, bis zu 500 MB. Diese ausgelieferte Grenze wurde auf fünf verschiedenen Dateiarten jeweils dreimal auf korrekte Ergebnisse geprüft (insgesamt 15 Läufe).
Die 15 Läufe deckten fünf Dateiformen ab: typische Daten, viele unterschiedliche Werte in den Vergleichsspalten, lange Vergleichswerte, sehr breite Zeilen und stark duplikathaltige Daten mit „letztes Vorkommen behalten“. Jede Form wurde dreimal ausgeführt und auf korrekte Ausgabe geprüft. Der schwierigste Fall mit 500 MiB war die Datei mit vielen unterschiedlichen Vergleichswerten: Die drei Läufe dauerten 43,1, 57,9 und 85,7 Minuten und benötigten ungefähr 1,472 GiB temporären Speicherplatz auf dem eigenen Rechner. Diese Messwerte stützen die aktuelle Grenze auf der Tool-Seite; dieser Dateityp kann jedoch lange dauern und ausreichend freien Speicherplatz erfordern.
Doppelte Zeilen schleichen sich aus banalen Gründen in CSV-Exporte ein: ein zweimal abgeschicktes Formular, ein Sync-Job, der doppelt lief, oder ein Tabellenexport, der denselben Datensatz aus zwei Quellsystemen enthielt. Bevor Sie einer Datei für den Import vertrauen können, müssen Sie Duplikate entfernen — korrekt, nicht nur die offensichtlich exakten.
Exakte Duplikate vs. logische Duplikate
Ein exaktes Duplikat ist eine Zeile, die in jedem Feld genau mit einer anderen übereinstimmt. Diese sind leicht zu erkennen. Ein logisches Duplikat ist trickreicher: zwei Zeilen, die denselben realen Datensatz darstellen, sich aber leicht unterscheiden, etwa derselbe Kunde mit zwei verschiedenen Telefonnummern, oder dasselbe Produkt mit einem Tippfehler im Namen.
Was als „derselbe Datensatz“ zählt, ist eine geschäftliche Entscheidung, keine technische — sie hängt davon ab, welche Spalte (oder Kombination von Spalten) eine eindeutige Entität in Ihren Daten zuverlässig identifiziert.
Abgleichsspalten wählen
| Datentyp | Starker Schlüssel | Schwacher Schlüssel (allein vermeiden) |
|---|---|---|
| Kunden | Vorname | |
| Produkte | SKU | Produktname |
| Firmen | Domain / Steuernummer | Firmenname |
Ist keine einzelne Spalte für sich zuverlässig, gleichen Sie anhand einer Kombination ab — etwa Name plus Geburtsdatum oder Firma plus Rechnungsadresse. Ein zu weit gefasster Abgleich erzeugt falsche Treffer; ein zu enger Abgleich übersieht echte Duplikate.
Testen Sie Ihre Abgleichsregel mit einer Stichprobe, bevor Sie sie auf die gesamte Datei anwenden. Ein zu lockerer Schlüssel kann zwei verschiedene Kunden zusammenführen; ein zu strenger lässt echte Duplikate übrig.
Was als Duplikat zählt
Das Werkzeug behandelt zwei Zeilen nur dann als Duplikate, wenn jede ausgewählte Schlüsselspalte denselben getrimmten Wert hat. Leerraum am Anfang oder Ende einer Schlüsselzelle wird ignoriert, sodass zwei Zeilen, die sich nur durch umgebende Leerzeichen unterscheiden, weiterhin ein Duplikat sind. Groß-/Kleinschreibung und Zeichensetzung innerhalb der Zelle werden nicht normalisiert — „Acme Corp“ und „acme corp.“ sind unterschiedliche Schlüssel.
Wählen Sie mehr als eine Schlüsselspalte, stimmen zwei Zeilen nur überein, wenn jede ausgewählte Spalte übereinstimmt. Die aktuelle Größengrenze liegt bei 500 MB pro Datei. Die Arbeit bleibt auf Ihrem Gerät — es wird nichts hochgeladen.
- 01
Eine CSV-Datei hochladen.
Wählen Sie die Datei mit den doppelten Zeilen. Es wird nichts hochgeladen — die Datei wird in Ihrem Browser gelesen und verarbeitet.
- 02
Eine oder mehrere Spalten für den Duplikatabgleich wählen.
Wählen Sie die Spalten, die zusammen einen Datensatz eindeutig identifizieren, etwa E-Mail allein oder Firma plus Kontaktname. Die Wahl der falschen Spalte führt zu einem Parse-Fehler, statt still ein falsches Ergebnis zu liefern.
- 03
Erstes oder letztes Vorkommen behalten.
„Erste behalten“ erhält die Zeile, die in der Datei am frühesten vorkam. „Letzte behalten“ erhält den jüngsten Eintrag. Wählen Sie das, was zur Sortierung Ihrer Datei passt und welche Kopie die vertrauenswürdigen Daten trägt.
- 04
Duplikatgruppen und bereinigte Vorschau prüfen.
Das Werkzeug zeigt, wie viele Duplikatgruppen gefunden wurden, und eine Vorschau der bereinigten Datei, bevor Sie herunterladen. Dies ist der Moment, um zu bestätigen, dass die Schlüsselregel tatsächlich das gefunden hat, was Sie beabsichtigt haben.
- 05
Bereinigte Datei oder entfernte Zeilen herunterladen.
Beide Dateien werden erzeugt: eine mit den entfernten Duplikaten und eine mit allem, was herausgefiltert wurde. Die Quelldatei wird nie verändert.
Erste oder letzte Zeile behalten?
Sobald Duplikate gruppiert sind, brauchen Sie eine Regel, welche Kopie erhalten bleibt.
- 01
Erste behalten
Bewahrt die Zeile, die in der Datei zuerst auftauchte — nützlich bei chronologisch sortierten Dateien mit dem Originaldatensatz.
- 02
Letzte behalten
Bewahrt den neuesten Eintrag — nützlich, wenn spätere Zeilen Korrekturen oder Aktualisierungen darstellen.
- 03
Manuell prüfen
Passt keine Regel, prüfen Sie die Duplikatgruppen vor der Entscheidung. Eine automatische Regel kann stillschweigend gute Daten verlieren.
Behalten Sie immer die entfernten Zeilen
Ein verantwortungsvoller Duplikat-Entfernungsprozess löscht Zeilen nicht einfach — er exportiert das Entfernte zusätzlich zur bereinigten Datei, damit Sie die Entscheidung stichprobenartig prüfen und eine Zeile wiederherstellen können, falls die Abgleichsregel zu aggressiv war. Die Datei der entfernten Zeilen verwendet dieselbe Spaltenreihenfolge und dasselbe Trennzeichen wie die Quelle, sodass sie ohne weitere Arbeit geöffnet oder wieder zusammengeführt werden kann. Wurde eine Zeile versehentlich entfernt, kopieren Sie sie aus dieser Datei zurück, statt die Bereinigung auf einer frischen Quelle erneut laufen zu lassen.
Wenn doppelte Zeilen unterschiedliche Werte enthalten und Sie entscheiden müssen, welcher Datensatz bleibt, lesen Sie zuerst den Leitfaden „erste oder letzte Zeile behalten“.
CSV-Duplikate entfernenTransformation ansehen
Doppelte Datensätze werden zu einer prüfbaren, sauberen Datei.
Doppelte Zeilen werden aus der sauberen Datei entfernt und bleiben leicht überprüfbar.
✓ Saubere Datei behält eine Kopie
Müssen Sie das jetzt erledigen?
CSV-Duplikate entfernenVerwandte Werkzeuge
Öffnen Sie das Werkzeug aus dieser Anleitung oder ein verwandtes.
- CSV-Dateien bereinigen und reparieren – ohne UploadBeheben Sie häufige CSV-Probleme wie falsche Trennzeichen, ungleiche Zeilen, Leerzeilen, Leerzeichen, BOM-Marker und doppelte Kopfzeilen.
- CSV-Dateien kostenlos online vergleichenVergleichen Sie zwei CSV-Dateien und prüfen Sie hinzugefügte, entfernte und geänderte Zeilen direkt im Browser.
- CSV-Spalten zuordnen und umbenennenBenennen, ordnen und entfernen Sie CSV-Spalten, bevor Sie Daten in ein CRM, einen Shop, eine Datenbank oder ein Buchhaltungssystem importieren – ganz ohne Upload.