
Comment comparer deux fichiers CSV (sans Excel)
Un guide pratique pour comparer deux exports CSV par colonne clé et repérer les lignes ajoutées, supprimées et modifiées sans jongler avec les formules du tableur.
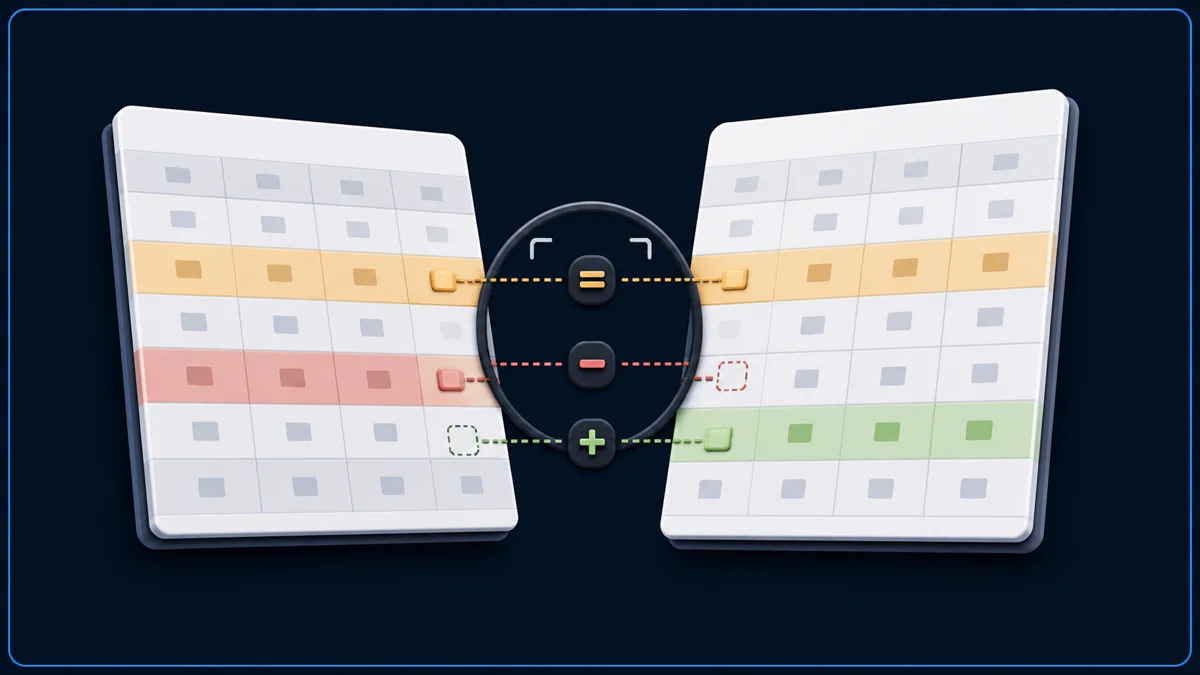
Pour comparer deux fichiers CSV, associez les lignes à l'aide d'une clé stable, comme un identifiant client, un SKU ou une adresse e-mail, puis répartissez le résultat entre lignes ajoutées, supprimées, modifiées et inchangées. Comparez les valeurs par nom de colonne plutôt que par position de ligne afin que les lignes insérées ou les colonnes réordonnées ne créent pas de faux écarts.
Quand une comparaison CSV est vraiment utile
Le cas le plus courant consiste à vérifier deux exports du même jeu de données pris à des moments différents : un catalogue produits avant et après une mise à jour fournisseur, une liste clients avant et après une synchronisation CRM, ou une grille tarifaire avant et après une revue.
C'est aussi utile pour valider une migration — exportez depuis l'ancien système, exportez depuis le nouveau, puis confirmez que rien n'a été perdu ou corrompu en transit.
CSV d'origine
CSV mis à jour
Ligne modifiée
Le client 1001 a changé d'offre, 1004 a disparu, et 1006 est nouveau — trois événements distincts qu'une simple lecture visuelle peut facilement manquer dans un fichier volumineux.
Choisissez d'abord une colonne clé stable
Une comparaison CSV ne vaut que ce que vaut la colonne utilisée pour associer les lignes. La position de la ligne n'est pas fiable — une seule ligne insérée ou supprimée décale tout ce qui suit et fait paraître énorme une différence sans rapport.
- 01
Trouvez une colonne unique
customer_id, SKU ou e-mail — une valeur présente exactement une fois par fichier.
- 02
Vérifiez la cohérence dans les deux fichiers
Même nom de colonne et même format dans l'ancien et le nouvel export.
- 03
Combinez des colonnes si nécessaire
Si aucune colonne seule n'est unique, combinez-en deux — e-mail et entreprise, par exemple.
Si vous n'êtes pas sûr qu'une colonne soit vraiment unique, comptez d'abord les doublons. Une clé avec seulement quelques valeurs répétées provoquera en silence des associations incorrectes pendant la comparaison.
Ce qu'une bonne comparaison doit réellement indiquer
Un résultat utile répartit les lignes en quatre groupes : ajoutées (présentes uniquement dans le nouveau fichier), supprimées (présentes uniquement dans l'ancien fichier), modifiées (même clé, valeurs différentes dans une ou plusieurs colonnes) et inchangées. Voir exactement quelles colonnes ont changé pour une ligne donnée, et pas seulement que « quelque chose » a changé, est ce qui rend le résultat exploitable.
| Statut | Signification | Présent dans le téléchargement |
|---|---|---|
| added | Ligne présente uniquement dans le second fichier | Incluse |
| removed | Ligne présente uniquement dans le premier fichier | Incluse |
| changed | Même clé dans les deux fichiers, au moins une colonne différente | Incluse, avec avant/après par colonne |
| unchanged | Même clé et valeurs identiques sur toutes les colonnes | Comptée dans le résumé, non incluse |
La comparaison téléchargée contient les lignes qui demandent votre attention : ajoutées, supprimées et modifiées. Les lignes inchangées restent visibles dans le résumé.
Lire les résultats à l'écran
L'espace de comparaison affiche les premières lignes de chaque catégorie. Le résumé indique combien de lignes ont été ajoutées, supprimées, modifiées ou sont restées identiques. Pour les lignes modifiées, l'aperçu montre les anciennes et nouvelles valeurs côte à côte. Téléchargez le résultat pour examiner les changements ailleurs.
Pièges courants qui produisent de fausses différences
Des colonnes réorganisées entre deux exports perturberont une comparaison naïve ligne par ligne même quand les données sont identiques — comparez par nom de colonne, pas par position. Les espaces en fin de valeur, une casse incohérente et différentes représentations des valeurs vides (chaîne vide vs. NULL vs. « N/A ») génèrent aussi du bruit qui n'est pas un vrai changement.
L'encodage des caractères compte aussi : un fichier enregistré en Windows-1252 et un autre en UTF-8 peuvent paraître différents à contenu identique si l'outil ne normalise pas d'abord l'encodage.
Les valeurs des cellules doivent correspondre exactement, y compris les espaces et la casse. Alice et alice sont différentes, tout comme NULL et une cellule vide. Nettoyez les fichiers d'entrée si ces différences n'ont pas d'importance pour vous.
Quand utiliser plutôt un outil associé
- Les deux fichiers ont des noms de colonnes différents : exécutez d'abord le mappeur de colonnes CSV pour aligner les en-têtes, puis revenez.
- Vous avez un seul fichier et voulez des lignes uniques : utilisez supprimer les doublons CSV.
- Vous voulez chaque ligne des deux fichiers jointe sur une clé partagée, pas seulement les différences : commencez par choisir le type de jointure et la bonne clé.
- Les données sont en JSON : convertissez avec JSON vers CSV ou comparez directement avec diff JSON.
Voir la transformation
Une comparaison utile sépare chaque type de changement.
Voyez séparément les lignes modifiées, ajoutées et supprimées afin de savoir exactement ce qui demande votre attention.
Besoin de le faire maintenant ?
Comparez vos fichiers CSVOutils associés
Ouvrez l'outil dont parle ce guide, ou explorez un outil associé.
- Supprimer les lignes CSV en double gratuitementChoisissez les colonnes qui définissent un doublon, prévisualisez le nettoyage et téléchargez le CSV nettoyé ainsi que les lignes supprimées.
- Mappeur et renommeur de colonnes CSVRenommez, réorganisez et supprimez des colonnes CSV avant d'importer des données dans un CRM, une boutique, une base de données ou un système comptable, sans téléverser vos fichiers.